


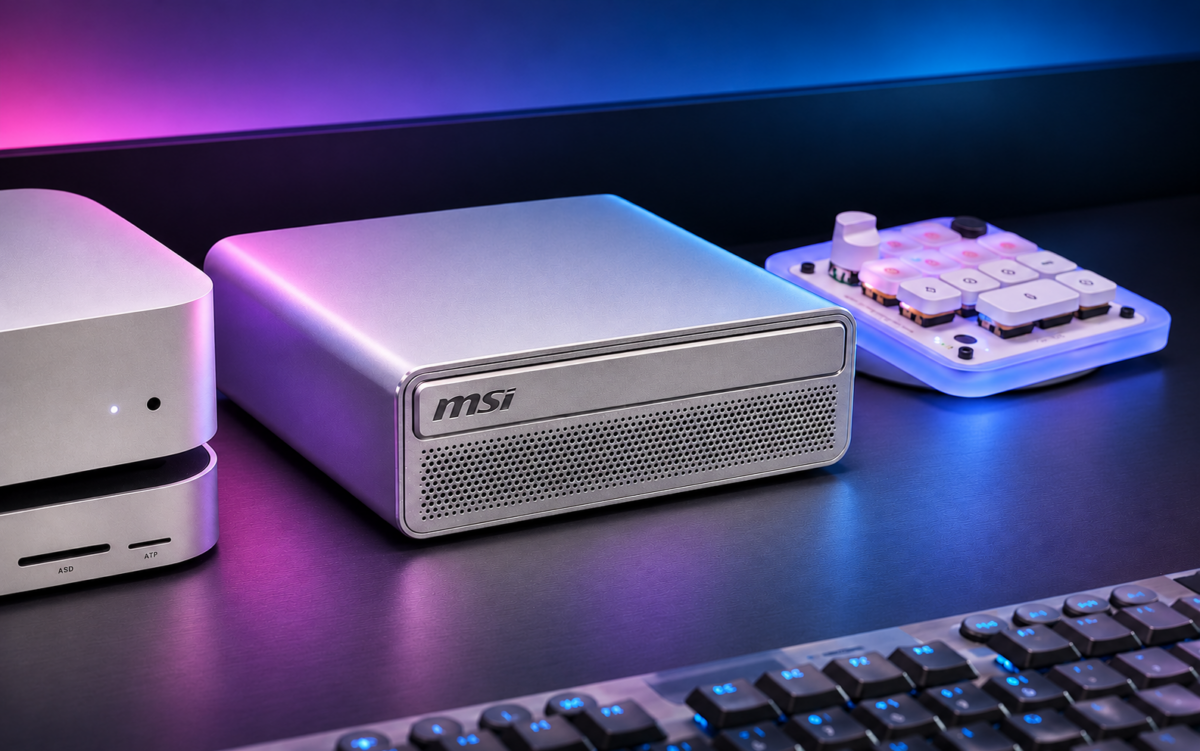
Nvidia appelle ça officiellement un « RTX Spark Compact Desktop ». MSI, lui, l’a baptisé EdgeMesa N AI+. Derrière ces deux noms se cache la même puce N1X que dans l’Asus ProArt P16 que j’ai testé il y a quelques semaines : un processeur ARM à 20 cœurs, un GPU Blackwell à 6 144 cœurs CUDA et 128 Go de mémoire partagés entre les deux. La différence tient au format. Ici, plus de batterie ni d’écran, mais un petit boîtier en aluminium qui consomme 16 W au repos et peut rester allumé jour et nuit.
C’est mon premier mini PC RTX Spark, et je l’ai abordé avec une question simple : à qui s’adresse une machine pareille ? Pour y répondre, je l’ai comparé au ProArt P16 (même puce), au Mac mini M6, au MacBook Pro M5 Max et aux mini PC AMD Strix Halo de GMKtec, sur huit modèles de langage, de la génération d’images, du jeu et des benchmarks classiques. Bref, un peu de tout.
Fiche technique du MSI EdgeMesa N AI+
| Modèle | MSI EdgeMesa N AI+ (référence MS-B215) |
| Système | Windows 11 Home ou Pro (Arm64), Pro sur notre exemplaire |
| Puce | NVIDIA RTX Spark N1X |
| CPU | NVIDIA Grace 20 cœurs ARM (10 performance, 10 efficacité) |
| GPU | NVIDIA Blackwell RTX, 6 144 cœurs CUDA, RT cores 4e génération, Tensor cores 5e génération |
| Performances IA | Jusqu’à 1 pétaflop en FP4 |
| Mémoire | 128 Go LPDDR5X-9600 unifiée, jusqu’à 96 Go réservables au GPU |
| Stockage | SSD M.2 NVMe PCIe 5.0 x4, jusqu’à 4 To (Samsung 4 To sur notre exemplaire) |
| Connectique arrière | 4 USB-C 20 Gb/s (3 en DisplayPort 2.1 Alt, 1 pour l’alimentation), 1 HDMI 2.1 FRL, 1 RJ45 10 Gb/s, verrou Kensington |
| Sans fil | Wi-Fi 7, Bluetooth 5.4 |
| Écrans | Jusqu’à 4 (HDMI 2.1 jusqu’à 4K 120 Hz ou 8K 60 Hz) |
| Refroidissement | Chambre à vapeur et deux ventilateurs |
| TDP annoncé | 140 W |
| Alimentation | Bloc externe 240 W |
| Dimensions | 152 x 147 x 53 mm (1,2 litre) |
| Prix | À partir de 4 399 dollars aux États-Unis (configurations RTX Spark Compact Desktop) |
L’exemplaire de ce test nous a été confié par Nvidia.
RTX Spark et DGX Spark, une même puce sous deux étiquettes
Nous avions testé le DGX Spark de NVIDIA dans sa version Dell, un mini PC à 128 Go de mémoire unifiée pensé pour les développeurs IA. L’EdgeMesa lui ressemble beaucoup, et pour cause. Nvidia a séparé les deux gammes par le logiciel : Linux (DGX OS) d’un côté pour le DGX Spark, Windows 11 de l’autre pour le RTX Spark. Sous le capot, on retrouve la même architecture et la même famille de puce, avec un CPU Grace conçu avec MediaTek et un GPU Blackwell.
La frontière est d’ailleurs assez poreuse. On peut installer Linux sur un RTX Spark, et Windows sur un DGX Spark. La distinction relève surtout du positionnement marketing : le DGX vise le labo et le développeur, le RTX Spark vise tout le monde, avec les pilotes Game Ready, DLSS et les applications créatives Windows. Je tousse un peu, mais c’est de bonne guerre.
Pour aller plus loin
Test du Nvidia DGX Spark (Dell) : le mini PC IA à 128 Go de RAM
Pour la présentation complète de la plateforme, ses ambitions et ses premiers résultats, je vous renvoie à notre test de Nvidia RTX Spark. Ici, je me concentre sur ce que change le format mini PC.
Le format mini PC, le plus cohérent pour RTX Spark
Sur le ProArt P16, la puce N1X devait cohabiter avec une batterie, un écran et un châssis fin. Nvidia la limite alors entre 45 et 80 W. Dans l’EdgeMesa, elle dispose d’une enveloppe de 140 W et d’un refroidissement dédié. Je m’attendais à un gros écart. Il est plus nuancé.

En génération de texte par IA, les deux machines font presque jeu égal : 63,7 tokens par seconde sur gpt-oss-120b pour le MSI, 63,3 pour l’ASUS. Ce débit dépend surtout de la bande passante mémoire, identique sur les deux. Le mini PC prend en revanche l’avantage dès que le calcul pur entre en jeu : +16 % en monocœur et +9 % en multicœur sur Cinebench 2026, +26 % de vitesse en génération d’images FLUX.2, et 5 à 9 % de mieux pour la lecture des prompts.
L’intérêt du format tient pourtant moins aux chiffres qu’à l’usage. Un modèle d’IA local n’a d’intérêt que s’il est disponible. Sur un PC portable, il s’éteint quand on ferme l’écran, il chauffe sur les genoux et vide la batterie. Le mini PC, lui, reste branché dans un coin du bureau. On garde un ultrabook léger dans le sac à dos et on se connecte à distance à son EdgeMesa pour interroger ses modèles, lancer une génération d’images ou piloter un agent. Pour un labo d’entreprise ou une salle de cours à l’université, le boîtier se range aussi très bien dans une baie.
Petit conseil au passage : si vous comptez vous y connecter en Bureau à distance Windows, prenez la version équipée de Windows 11 Pro. L’édition Home ne peut pas héberger de session RDP. Au pire, vous pourrez installer Windows 11 Pro… Des solutions comme Tailscale, Parsec ou une simple connexion SSH vers un serveur llama.cpp fonctionnent dans tous les cas. C’est ce que j’utilise.
Pour aller plus loin
Test de l’Asus ProArt P16 : j’ai vécu une semaine avec le premier PC portable Arm de Nvidia
Design : un petit boîtier fait pour se faire oublier
Avec ses 152 x 147 x 53 mm, l’EdgeMesa occupe à peine plus de place qu’un Mac mini posé à plat. Le châssis est entièrement en aluminium, avec une finition mate qui retient peu les traces de doigts. Le résultat fait sérieux, presque austère.

La façade m’a amusé dès le déballage. Sa fine découpe horizontale donne l’impression qu’un lecteur de DVD slim s’y cache, comme sur un boîtier de salon des années 2000. Il n’y en a évidemment pas : cette fente est décorative. L’effet est un peu rétro, mais le boîtier passe partout, sous un écran, à côté d’une box ou sur une étagère.
Tout a été pensé pour qu’on l’oublie. Pas d’éclairage RGB, pas de logo clinquant, et une ventilation que je n’ai jamais entendue en usage bureautique. Pour une machine destinée à tourner en continu, c’est exactement ce qu’il fallait.

Connectiques : rapide, mais sans USB-A
Toute la connectique se trouve à l’arrière. On y trouve quatre ports USB-C à 20 Gb/s, dont trois compatibles DisplayPort 2.1, un HDMI 2.1 capable d’afficher de la 4K à 120 Hz ou de la 8K à 60 Hz, un port Ethernet 10 Gb/s (contrôleur Realtek RTL8127) et un verrou Kensington. Le Wi-Fi 7 et le Bluetooth 5.4 complètent l’ensemble. Jusqu’à quatre écrans peuvent être pilotés en même temps.

Le 10 Gb/s est un vrai plus pour un serveur IA. Il permet de charger un modèle de 60 Go depuis un NAS en une minute environ, ou de servir plusieurs postes du réseau sans goulot d’étranglement.
Deux choses me gênent davantage. Il n’y a aucun port USB-A, ce qui obligera à passer par un adaptateur pour une clé USB ancienne ou un récepteur de souris. Et l’un des quatre ports USB-C sert à l’alimentation, via le bloc externe de 240 W. Il en reste donc trois de libres, tous à l’arrière. Un port en façade aurait été bienvenu pour brancher une clé de temps en temps. Forcément, c’est un peu moins esthétique.
Un bug d’affichage HDMI à surveiller
J’ai rencontré un souci récurrent pendant le test. De temps en temps, l’écran branché en HDMI (un Dell en 2 560 x 1 440) restait noir alors que le PC fonctionnait. Le problème est arrivé au démarrage, mais aussi en pleine utilisation. Débrancher puis rebrancher le câble HDMI suffisait à retrouver l’image.
Ce qui est étrange est que les journaux Windows ne montrent aucune erreur liée au pilote graphique ou au matériel. Je n’ai pas pu isoler la cause (câble, écran, pilote ou firmware) dans le temps imparti. Je pense que ça sera réglé avec les futures versions des pilotes Nvidia.
Silence et consommation : presque inaudible
C’est sans doute la qualité qui m’a le plus séduit. Au repos, j’ai relevé entre 26 et 27 dB à proximité de la machine, bref, on entend rien. Les ventilateurs sont inaudibles. Seul un léger grésillement électronique se fait entendre en tendant l’oreille, le même que j’avais remarqué sur le ProArt P16.
Sous forte charge, que ce soit un rendu Cinebench ou un modèle d’IA qui avale un document de 16 000 tokens, le bruit monte à 45 dB environ. On entend un souffle discret, sans sifflement aigu. Le boîtier tiédit, sans plus. Le système de refroidissement, que MSI appelle AI Pulse Cooling (une chambre à vapeur et deux ventilateurs), fait très bien son travail.


Sécurisez vos achats durant Black Friday avec la meilleure offre de l’année. Dénichez les bonnes affaires, Bitdefender s’occupe des arnaques.

| Scénario | Consommation à la prise | Bruit relevé |
|---|---|---|
| Repos | 14 à 16,6 W | 26 à 27 dB |
| Cinebench multicœur (CPU) | 129 W | jusqu’à 45 dB |
| IA, lecture d’un prompt de 16 384 tokens | 183 W | 45,2 dB |
| Cyberpunk 2077, path tracing | 196 W | non relevé |
Ces 16 W au repos comptent beaucoup pour une machine allumée en permanence. Sur une année, cela représente environ 140 kWh, soit une trentaine d’euros d’électricité au tarif réglementé actuel. Les pics à 183 et 196 W dépassent le TDP de 140 W annoncé par MSI, mais ce dernier ne concerne que la puce, alors que mon wattmètre mesure toute la machine, pertes du bloc d’alimentation comprises.

Un mot sur MSI Center, le logiciel maison. Après installation, il ne propose qu’une synchronisation du presse-papiers et l’affichage sans fil. Aucun profil de puissance n’est disponible. Passer Windows en mode « Meilleures performances » n’apporte qu’environ 2 % en CPU, et rien de mesurable en IA. Le mode équilibré par défaut suffit largement.

Une puce ARM sous Windows
Il faut le rappeler : la N1X est une puce ARM, comme celles des Mac ou des Snapdragon X. Son processeur Grace compte 10 cœurs performance et 10 cœurs efficacité, conçus avec MediaTek. L’EdgeMesa tourne donc sous Windows 11 Arm64.
En pratique, la situation s’est nettement améliorée par rapport aux premiers PC Windows sur ARM. Les outils IA (llama.cpp, Ollama, LM Studio, ComfyUI) existent en version native ARM64 avec CUDA. Adobe a sorti des versions natives de Photoshop, Premiere, Illustrator et InDesign, et Blender suit. Les applications x64 restantes passent par la couche d’émulation de Windows. Cyberpunk 2077, par exemple, tourne en x64 émulé, ce qui ne l’empêche pas de bien s’en sortir comme on le verra plus loin.
Le jeu en ligne reste le point à vérifier. Selon Nvidia, les anti-triche d’Epic (Fortnite, Rocket League), de BattlEye (Rainbow Six Siege) ou de Valve (Counter-Strike 2) fonctionnent déjà nativement. Ceux de Riot (Valorant, League of Legends) et d’Activision (Call of Duty) sont annoncés « prochainement ».
La mémoire unifiée, le cœur du sujet
Sur un PC classique, la carte graphique possède sa propre mémoire, la VRAM. Une GeForce RTX 5090, la plus haut de gamme, en embarque 32 Go. Pour faire tourner un modèle d’IA rapidement, il faut que ses poids tiennent dans cette VRAM. Un modèle de 60 Go ne rentre donc dans aucune carte graphique grand public.

Sur la N1X, le CPU et le GPU partagent les mêmes 128 Go de LPDDR5X. Ils communiquent via la liaison NVLink-C2C de Nvidia, annoncée à 600 Go/s. Le GPU peut ainsi travailler sur un modèle de 60 ou 90 Go sans copie d’une mémoire à l’autre. C’est la même logique que la mémoire unifiée des puces Apple ou des AMD Strix Halo. J’ai mesuré une bande passante de 139 Go/s côté CPU avec STREAM, au niveau du ProArt (139,8 Go/s).
Régler la part réservée au GPU
Toute la mémoire n’est pas disponible pour le GPU d’office. Par défaut, Nvidia lui réserve 62,5 Go sur les 128 Go. On peut monter jusqu’à 96 Go depuis l’application NVIDIA App, dans Système, puis Avancé, à l’aide d’un curseur. Un redémarrage est ensuite demandé. C’est ce que j’ai fait pour ce test : après redémarrage, l’outil nvidia-smi affichait bien 98 304 Mio de mémoire GPU (96 Gio).
| Mémoire totale | Minimum GPU | Par défaut | Maximum GPU |
|---|---|---|---|
| 24 Go | 4 Go | 8 Go | 8 Go |
| 32 Go | 4 Go | 12 Go | 16 Go |
| 48 Go | 4 Go | 16 Go | 32 Go |
| 64 Go | 4 Go | 30,5 Go | 48 Go |
| 128 Go | 4 Go | 62,5 Go | 96 Go |
Nvidia m’a prévenu : augmenter la part du GPU « laisse moins de mémoire pour Windows et les applications CPU ». Avec 96 Go réservés, il reste une trentaine de gigaoctets au système, ce qui suffit pour travailler normalement à côté. Pour du jeu ou de la création pure, la valeur par défaut convient très bien. Pour l’IA locale avec de gros modèles, je conseille de passer directement au maximum.
Pourquoi il faut redémarrer
On pourrait s’attendre à ce que la répartition s’ajuste toute seule, à la volée. Ce n’est pas le cas ici. La réservation GPU est fixée au démarrage de la machine, avant que Windows ne commence à distribuer la mémoire aux applications. Le pilote graphique dispose alors d’un bloc qui lui appartient, comme une VRAM classique. Modifier ce découpage en cours de session obligerait à déloger des données déjà installées par Windows ou par le GPU dans la zone concernée, ce que le système ne permet pas de faire proprement.
Apple procède différemment : sur Mac, le GPU puise dynamiquement dans la mémoire commune, jusqu’à un plafond (environ 75 % par défaut) que l’on peut relever en ligne de commande. C’est plus souple au quotidien. L’approche de Nvidia est plus rigide, mais aussi plus prévisible : une fois réglée, la mémoire GPU est garantie, et un gros modèle ne risque pas de se faire évincer par Chrome. Dans un usage de serveur IA toujours allumé, on règle le curseur une fois et on n’y touche plus.
IA locale : des modèles de pointe chez soi
L’IA locale est la raison d’être de l’EdgeMesa. Avec 96 Go de mémoire GPU, il fait tourner des modèles ouverts de très haut niveau, proches de ce que proposent les grands services en ligne.
Nvidia met en avant Qwen3.8 Flash-Next, un modèle de 177 milliards de paramètres. Selon le classement indépendant Artificial Analysis cité par NVIDIA, il obtient un indice d’intelligence de 40, contre 41 pour Claude Sonnet 5.5 en mode Medium. Pour comparer vous-même les modèles par usage, locaux comme en ligne, le site QUELLE IA tient un classement à jour. C’est une plateforme que je maintiens depuis septembre dernier.
Huit modèles testés, tous chargés
J’ai mesuré huit modèles avec llama.cpp (build b11582, CUDA ARM64), de 5 à 94 Go. Tous ont chargé sans problème. Le tableau ci-dessous indique la vitesse de génération, c’est-à-dire le nombre de tokens produits par seconde. Un token correspond grosso modo à un morceau de mot ; au-delà de 20 tokens par seconde, la réponse s’affiche plus vite qu’on ne la lit.
| Modèle | Taille | MSI EdgeMesa | ASUS ProArt P16 | GMKtec EVO-X2 (395) | GMKtec EVO-X5 Pro (495) | MacBook Pro M5 Max |
|---|---|---|---|---|---|---|
| Qwen3 8B | 5 Go | 53,2 | 53,1 | 45,0 | 46,0 | 98,7 |
| Qwen3.8 27B | 16,4 Go | 16,3 | 16,3 | 13,2 | 13,7 | 29,4 |
| Qwen3.6 35B-A3B | 22,1 Go | 74,6 | 74,9 | 64,7 | 64,3 | 109,1 |
| gpt-oss-120b | 63,4 Go | 63,7 | 63,3 | 56,7 | 56,8 | 107,1 |
| gpt-oss-20b | 13,8 Go | 65,8 | 63,4 | 54,0 | 52,9 | 109,3 |
| Qwen3-Coder 30B | 18,6 Go | 108,2 | 104,7 | 91,7 | 96,5 | 154,4 |
| Nemotron 3.5 30B | 35 Go | 68,4 | 67,4 | 57,1 | 59,4 | 106,2 |
| Qwen3.8 Flash-Next | 93,7 Go | 28,1 | 25,6 | 28,5 | 27,8 | 50,2 |

Les écarts de vitesse entre modèles s’expliquent par leur architecture. Qwen3.8 27B est un modèle « dense » : les 27 milliards de paramètres travaillent pour chaque token, d’où ses 16 tokens par seconde. Qwen3-Coder 30B, Qwen3.6 35B-A3B ou gpt-oss-120b sont des modèles « à mélange d’experts » (MoE) : seule une petite partie des paramètres s’active à chaque token, environ 3 milliards pour le Coder. Résultat, un fichier de taille voisine génère 6,6 fois plus vite. C’est pour cette raison que gpt-oss-120b, malgré ses 63 Go, dépasse les 60 tokens par seconde.

Lire un document et répondre : deux vitesses distinctes
Un modèle d’IA travaille en deux temps. Il lit d’abord l’ensemble du prompt (la question, mais aussi le document joint ou l’historique de conversation), puis il génère sa réponse. La première étape dépend surtout de la puissance de calcul, la seconde de la bande passante mémoire. Et sur la lecture, l’EdgeMesa se défend bien mieux.
| Modèle | MSI EdgeMesa | ASUS ProArt P16 | GMKtec EVO-X2 | GMKtec EVO-X5 Pro | MacBook Pro M5 Max |
|---|---|---|---|---|---|
| Qwen3 8B | 3 499 | 3 216 | 1 343 | 1 337 | 2 803 |
| Qwen3.8 27B | 988 | 911 | 401 | 391 | 769 |
| Qwen3.6 35B-A3B | 2 878 | 2 633 | 1 584 | 1 728 | 3 336 |
| gpt-oss-120b | 2 190 | 2 083 | 1 089 | 1 157 | 2 057 |
| gpt-oss-20b | 5 318 | 5 025 | 1 891 | 2 141 | 3 907 |
| Qwen3-Coder 30B | 3 164 | 2 994 | 1 668 | 1 822 | 3 601 |
| Nemotron 3.5 30B | 2 363 | 2 242 | 1 567 | 1 684 | 2 934 |
| Qwen3.8 Flash-Next | 457 | 320 | 572 | 611 | 1 149 |
Face aux machines AMD, l’EdgeMesa lit les prompts 1,5 à 2,8 fois plus vite selon les modèles. Face au M5 Max, le classement dépend du modèle : NVIDIA l’emporte sur gpt-oss-120b, gpt-oss-20b et les deux Qwen denses, Apple sur les autres. Flash-Next fait exception : sur ce modèle, le MSI lit moins vite que les AMD et que le Mac.

Cette différence compte dans la vraie vie. J’ai soumis à Qwen3.6 35B-A3B des documents de 4 096 à 65 536 tokens (environ une centaine de pages pour le plus long), avec une information cachée à retrouver. Le modèle a répondu juste à chaque fois. Le délai avant le premier mot passe de 1,7 seconde pour 4 096 tokens à 30,7 secondes pour 65 536 tokens.

Décodage spéculatif et endurance
Nvidia pousse une technique appelée décodage spéculatif. Un petit modèle « brouillon » propose plusieurs tokens d’avance, que le gros modèle valide en une seule passe. Avec DFlash sur Qwen3.8 27B, la génération passe d’environ 16 tokens par seconde à 33 sur un texte rédigé, 46 sur un problème de raisonnement et 49 sur du code. Soit un facteur de 2 à 3,1 selon les cas. Les réponses obtenues ne sont pas strictement identiques à celles du mode classique ; je n’ai pas évalué si leur qualité était équivalente.

Côté endurance, j’ai enchaîné trente générations de 1 024 tokens sur Qwen3.6 35B-A3B, soit sept minutes de travail continu. Le débit moyen s’établit à 72,9 tokens par seconde, avec une baisse de 2,4 % seulement entre le début et la fin. Le GPU n’a pas dépassé 69 °C.

Quels outils, quels agents, pour quoi faire
Disposer de bons modèles ne suffit pas, il faut aussi un « harnais » pour les utiliser : un serveur qui les fait tourner, une interface pour discuter avec eux, et éventuellement un agent capable d’agir sur la machine. Sur l’EdgeMesa, le socle logiciel est le même que sur n’importe quel PC Nvidia, puisque tout repose sur CUDA.
| Usage | Modèle conseillé | Outils |
|---|---|---|
| Assistant de conversation polyvalent | Qwen3.6 35B-A3B (75 tok/s) | LM Studio, Ollama, Open WebUI |
| Agent de code | Qwen3-Coder 30B (108 tok/s) | OpenCode, Claude Code ou Codex CLI branchés sur un serveur llama.cpp local |
| Raisonnement, gros documents | gpt-oss-120b (64 tok/s) | llama.cpp serveur, Open WebUI avec RAG |
| Qualité maximale en local | Qwen3.8 Flash-Next (28 tok/s) | llama.cpp avec les recettes Nvidia |
| Agent personnel | Qwen3.8 27B ou 35B-A3B | Hermes avec routage Switchyard |
| Images et vidéo | FLUX.2, LTX 2.5 en NVFP4 | ComfyUI Desktop ARM64 |
Je vous recommande Hermes pour démarrer avec un agent. On lui connecte sa messagerie, son agenda ou ses applications créatives, puis on lui confie des tâches : installer une liste de logiciels en version ARM, préparer un briefing chaque matin à 8 h, transformer des notes de réunion en liste d’actions. Le module Switchyard tente chaque requête en local et ne bascule vers un modèle en ligne payant que lorsque la tâche l’exige. On peut aussi parler à son agent depuis son smartphone via Telegram, WhatsApp ou Discord, tant que le PC reste allumé, ce qui convient parfaitement à un mini PC branché en permanence.
Pour la domotique, Nvidia imagine même le RTX Spark en « agent du foyer », relié à Home Assistant pour surveiller les capteurs de fuite, les volets ou l’arrosage. Cela se fait, je le fais déjà depuis un NAS… commandé par un agent IA.
Côté développeurs, l’affinage de modèles est possible : selon les chiffres de NVIDIA, Unsloth adapte Qwen3-32B en QLoRA sur 500 exemples en 14 minutes.
Côté coût, Nvidia calcule qu’un RTX Spark générant 61 millions de tokens par mois avec Flash-Next consommerait environ 20 dollars d’électricité, contre 1 200 dollars de frais d’API chez Anthropic pour un volume équivalent. Ce calcul suppose une machine qui travaille près de 20 heures par jour, ce qui ne correspond pas à un usage personnel. Il montre surtout qu’au-delà d’un certain volume, l’investissement se rentabilise. Mais, j’insiste, l’argument principal reste la confidentialité : rien ne quitte la machine.
Si vous voulez monter votre propre installation, mon guide mini lab AI détaille la mise en place d’une IA locale sous Windows, macOS ou Linux, des serveurs aux agents. Et pour savoir quels modèles locaux tournent sur ces machines, la page RTX Spark de QUELLE IA recense les options compatibles.
Face au Mac mini M6, au MacBook Pro M5 Max et aux AMD Strix Halo
Le marché des machines à mémoire unifiée s’est bien rempli en un an. Voici comment l’EdgeMesa se situe face à ses principaux concurrents.
| MSI EdgeMesa | Mac mini M6 | MacBook Pro M5 Max | GMKtec EVO-X2 | GMKtec EVO-X5 Pro | |
|---|---|---|---|---|---|
| Puce | NVIDIA N1X | Apple M6 | Apple M5 Max | AMD Ryzen AI Max+ 395 | AMD Ryzen AI Max+ PRO 495 |
| Mémoire testée | 128 Go | 24 Go | 128 Go | 128 Go | 192 Go |
| gpt-oss-120b (génération) | 63,7 tok/s | impossible | 107,1 tok/s | 56,7 tok/s | 56,8 tok/s |
| Geekbench 7 monocœur | 2 616 | 3 997 | 3 759 | 2 742* | 2 712 |
| Geekbench 7 multicœur | 22 900 | 22 542 | 35 526 | 26 370* | 28 192 |
| Cinebench 2026 multicœur | 7 122 | 5 472 | 9 498 | 7 819* | 7 794 |
| 3DMark Steel Nomad | 3 355 | 1 506 | non mesuré | non mesuré | non mesuré |
Face au Mac mini M6. Le Mac mini M6 reste la machine idéale pour la plupart des gens, et ce n’est pas le même produit. Il est nettement plus rapide en monocœur (+53 % sur Geekbench), ce qui se ressent dans la réactivité du système. En multicœur, les deux font jeu égal sur Geekbench, et le MSI prend 30 % d’avance sur Cinebench. En graphisme, l’EdgeMesa double le score Steel Nomad. Mais surtout, avec 24 Go, le Mac mini plafonne à environ 18 Go utilisables par le GPU : il faut déjà forcer les réglages pour charger un modèle de 30 milliards de paramètres. Les 120 milliards de gpt-oss lui sont inaccessibles.

Face au MacBook Pro M5 Max. Le MacBook Pro 16 pouces M5 Max avec 128 Go reste plus rapide en génération de texte sur les huit modèles, de 40 à 85 % selon les cas. Sa bande passante mémoire plus élevée fait la différence. Le MSI reprend l’avantage sur la lecture de plusieurs modèles et surtout en génération d’images : 21,6 secondes contre 36,2 secondes pour une même image FLUX.2 en BF16, et 12,8 secondes en NVFP4, un format que le Mac ne gère pas. Le M5 Max est aussi un portable haut de gamme, vendu plus cher. Nous n’avons pas encore testé le Mac Studio, qui sera le vrai concurrent de bureau, il arrive bientôt… on l’attend à la rédac.

Face aux AMD Strix Halo. Le GMKtec EVO-X2 et sa Ryzen AI Max+ 395 reste l’un des mini PC IA les plus abordables avec 128 Go. L’EdgeMesa génère 12 à 23 % plus vite sur sept modèles sur huit, et lit les prompts jusqu’à 2,8 fois plus vite. Le récent GMKtec EVO-X5 Pro et sa Ryzen AI Max+ PRO 495 monte à 192 Go de mémoire, mais ne génère pas plus vite que le 395 sur ces modèles qui tiennent déjà dans 128 Go. Son intérêt se situe ailleurs, pour des modèles plus gros encore. Côté CPU, les deux AMD dominent le MSI en multicœur, de 10 à 23 % selon le test. Nvidia conserve un avantage décisif avec CUDA : la plupart des outils IA sont optimisés pour lui en premier, et les nouveaux modèles y fonctionnent dès leur sortie.


Pour une vue d’ensemble de ces machines et de leurs alternatives, notre guide des meilleurs mini PC pour l’IA locale fait le point.
Création : l’atout du format NVFP4
Pour la génération d’images, j’ai utilisé ComfyUI avec FLUX.2 Klein 4B, en 20 étapes. Le GPU Blackwell gère le format NVFP4, une façon de stocker les poids du modèle sur 4 bits qui réduit la mémoire occupée et accélère les calculs. NVIDIA le recommande pour toutes ses puces récentes.
| Scénario FLUX.2 Klein 4B | MSI EdgeMesa (NVFP4) | ASUS ProArt P16 (NVFP4) | MacBook Pro M5 Max (BF16) |
|---|---|---|---|
| 1 image 1 024 x 1 024 | 12,8 s | 16,2 s | 36,2 s |
| 1 image 2 048 x 2 048 | 81,9 s | 90,8 s | 215,5 s |
| Lot de 4 images 1 024 x 1 024 | 52,6 s | 60,1 s | 146,6 s |
| 1 image 1 024 x 1 024 en BF16 | 21,6 s | non mesuré | 36,2 s |


Pour la vidéo et la 3D, je n’ai pas mené mes propres mesures. NVIDIA annonce pour les mini PC RTX Spark un score de 84 155 points sur PugetBench Premiere Pro, 1 881 points sur la scène Monster de Blender 5.3 et un encodage NVENC capable de traiter des rushes HEVC 10 bits 4:2:2. L’EdgeMesa se débrouillera très bien pour du montage, à condition de garder en tête que la mémoire est partagée. Pour un usage purement créatif, avec de grosses scènes 3D ou des projets vidéo lourds, les 128 Go du modèle testé me semblent le minimum raisonnable, puisque le GPU et les logiciels piochent dans le même réservoir. Un PC classique avec une GeForce RTX bien dotée en VRAM reste une alternative plus simple.
Jeu vidéo : un vrai PC RTX, mais ce n’est pas un PC de joueur
Le RTX Spark profite de toute la panoplie NVIDIA : ray tracing, DLSS 4.5 et 5, génération d’images multiple, Reflex. J’ai lancé Cyberpunk 2077 (version 2.5) en 2 560 x 1 440, avec le pilote 621.24 Game Ready. Le jeu tourne en x64 via l’émulation de Windows.
| Réglages Cyberpunk 2077 (1440p) | Images par seconde |
|---|---|
| Ultra natif, sans ray tracing | 60,7 |
| RT Ultra, DLSS Qualité | 43,4 |
| Path tracing, DLSS Qualité, Ray Reconstruction | 30,2 |
| Path tracing + génération d’images x2 | 53,5 |
| Path tracing + génération d’images x4 | 96,8 |


Jouer en path tracing à 1440p sur un boîtier de 1,2 litre reste une jolie prouesse. Avec la génération d’images x4, on approche les 100 images par seconde affichées, même si la réactivité correspond plutôt aux 30 images réellement calculées. Sur 3DMark, le MSI obtient 3 355 points sur Steel Nomad et 3 169 points sur Speed Way, en ligne avec les 3 141 points annoncés par NVIDIA. Le niveau global correspond à une carte graphique de milieu de gamme.

Pour jouer, l’EdgeMesa fait donc très bien le travail. Mais je ne l’achèterais pas pour ça. À ce prix, une tour équipée d’une GeForce RTX classique offre bien plus d’images par seconde, aucune question de compatibilité ARM ou d’anti-triche, et la possibilité de changer de carte graphique plus tard. Le jeu est ici un bonus appréciable pour une machine achetée pour autre chose.
Performances CPU et SSD
Le processeur Grace à 20 cœurs obtient 2 616 points en monocœur et 22 900 points en multicœur sur Geekbench 7. Sur Cinebench 2026, il atteint 545 points en monocœur et 7 122 points en multicœur. C’est confortable pour du développement, de la compilation ou du multitâche lourd, mais en retrait face aux puces Apple en monocœur et aux AMD en multicœur.

Le SSD Samsung de 4 To en PCIe 5.0 est très rapide : 14,3 Go/s en lecture séquentielle et 12,9 Go/s en écriture, plus de 300 000 IOPS en lecture aléatoire. Charger un modèle de 63 Go comme gpt-oss-120b prend quelques secondes. Ces mesures portent sur des fichiers courts ; je n’ai pas testé le comportement lors de très longues copies.

Prix et disponibilité du MSI EdgeMesa N AI+
Les mini PC RTX Spark sont disponibles à partir du 18 novembre 2026. Nvidia annonce un prix de départ de 4 399 dollars aux États-Unis pour ces RTX Spark Compact Desktop, tous équipés de la N1X complète et de 128 Go de mémoire. Le MSI EdgeMesa N AI+ est proposé avec Windows 11 Home ou Pro et un SSD allant jusqu’à 4 To. Le prix français de notre configuration (Windows 11 Pro, 4 To) est de 8189,99 €.
Il n’y a pas d’offres pour le moment, découvrez :
 GMKtec EVO-X2 AI1 899,99 €Voir l’offre
C’est cher, évidemment. À titre de repère, un GMKtec EVO-X2 avec 128 Go + 2 To coûte nettement moins (3499,99 €), au prix de performances IA inférieures et d’un écosystème logiciel moins mûr. Pour comparer toutes les options, consultez notre sélection des meilleurs mini PC pour faire tourner une IA en local.
Pour aller plus loin
Quel mini PC choisir pour l’IA ? Notre sélection 2026


Ce contenu est bloqué car vous n'avez pas accepté les cookies et autres traceurs. Ce contenu est fourni par Disqus.
Pour pouvoir le visualiser, vous devez accepter l'usage étant opéré par Disqus avec vos données qui pourront être utilisées pour les finalités suivantes : vous permettre de visualiser et de partager des contenus avec des médias sociaux, favoriser le développement et l'amélioration des produits d'Humanoid et de ses partenaires, vous afficher des publicités personnalisées par rapport à votre profil et activité, vous définir un profil publicitaire personnalisé, mesurer la performance des publicités et du contenu de ce site et mesurer l'audience de ce site (en savoir plus)
En cliquant sur « J’accepte tout », vous consentez aux finalités susmentionnées pour l’ensemble des cookies et autres traceurs déposés par Humanoid et .
Vous gardez la possibilité de retirer votre consentement à tout moment. Pour plus d’informations, nous vous invitons à prendre connaissance de notre Politique cookies.